很多 PDM 和 PLM 系统都能保存生产文件。上传一份 A.dxf,服务器记录一条 A.dxf,看起来管理已经完成。但如果这条记录真正提供的信息只有文件路径,它对生产效率、BOM 完整性和文件关联性的贡献都接近于零。
更值得关注的是文件背后的数据源。生产文件不是独立存在的对象:工程图来自零件,平面图、PDF、DXF 又来自工程图;数模输出同样来自零件。只记录创建时间或版本更新时间,很容易让人误以为系统已经建立了追溯关系,实际却没有解释“这份文件属于哪个物料、为什么存在、下一次应从哪里重新生成”。
PDM/PLM 记录 A.dxf,真正贡献了什么
把 A.dxf 放进服务器,最直接的价值只是知道它在哪里。它对生产类型的判断没有贡献,对 BOM 完整性没有贡献,对文件之间的关联也没有贡献。时间与版本字段看似有用,但如果工程图和数模都由零件刷新产生,这些字段只是结果的时间,不是数据关系本身。
真正要解决的问题不是“如何保存更多文件”,而是“如何从唯一的数据源找到这一份物料对应的全部生产文件”。
从文件记录转向数据源检索
另一种方式是:设计数据源中保留物料的固定代号,检索代码依据这个代号找到对应的 A.dxf。数据源保存在 BOM 表中,BOM 变化,检索结果随之变化。
从全局看,A.dxf、A.pdf、A.stp、A.sldprt、A.slddrw 都在表达同一份物料。如果每种格式都创建一个独立的全局主键,维护的是技术文件,而不是现实中的物料。剥离这些重复主键,才能让结构更简单。
更关键的是:唯一数据源一旦变化,整条生产文件链路才能一起变化。这正是自动输出和下游分发的前提。
SWTDO 的二重索引
SWTDO 把这个过程称为二重索引:第一重索引是数据表记录,第二重索引是代码根据记录自动搜索文件。数据记录负责表达业务关系,代码负责把关系转化为实际文件结果。
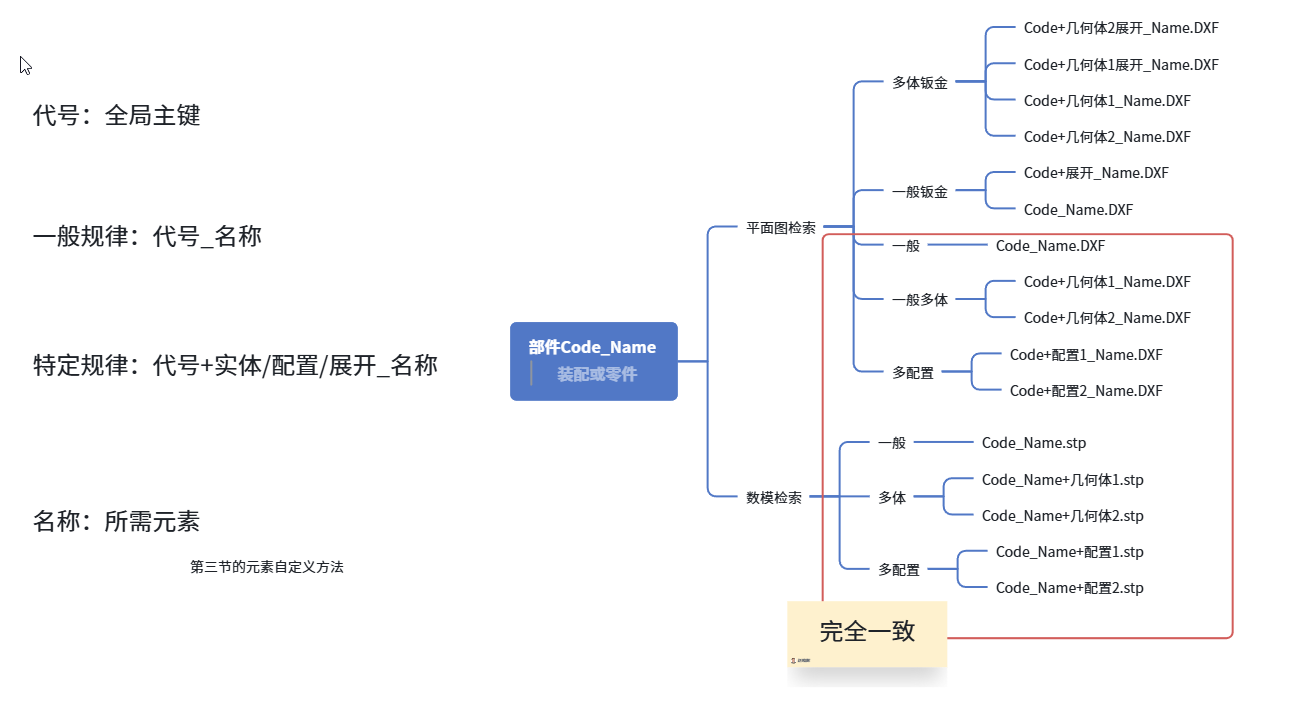
命名采用 Code_Name 的形式。Code 是全局主键,Name 让文件具象化、便于识别。全局主键已经保证唯一性,因此常规检索不再依赖 Ver。版本信息可以保留为历史快照,但不应继续充当主索引。
版本控制并非无用,但不适合作为主索引
老客户的维保确实需要历史追溯。例如十年前交付的 CQ 气缸已经经历多轮技术改进,今天要替换旧部件,就需要从销售记录追到当时的图纸版本,再找到对应零件。这个销售节点相当于一个可以回退的 Fork 节点。
但这种场景与日常检索并不是同一种需求。日常生产文件应优先从唯一数据源和全局主键检索;只有合同、维保或旧项目快照需要回到历史版本。把例外场景做成全系统的主索引,会让所有普通任务都背负版本控制成本。
多体、多配置与钣金展开图的命名扩展
第二重索引的规则可以保持简单:后缀不同,文件名主体相同。例如:
Code_Name.sldprt → Code_Name.slddrw → Code_Name.dxfCode_Name.sldprt → Code_Name.stp
遇到多体、多配置时,建立文件与宿主的关系;钣金还需要增加专用展开图输出,因此写成 Code+实体名_Name.slddrw。分隔符固定使用 + 和 _,不使用空格,这样对日语和英语用户都更稳定,也便于 Prod 系统和 Windows 资源管理器排序。
排序本身也很有价值。只要文件能够稳定排序,就不需要每次都重新查询;服务器上一个固定的 order 往往比构造复杂视图更简单。
最终得到的是可联动的生产文件链
设计修改 BOM 后,系统即可依据 BOM 找到整套生产文件并执行分发。采购、组装和其他下游部门在获得相应阅读权限后,也能从客户端取得自己需要的资料。这里的关键不是多做一个文件清单,而是让 BOM、文件检索、权限和生产输出共享同一套数据关系。